KI-Hosting & Datensouveränität
KI nutzen. Daten schützen. Kontrolle behalten.
KI soll Unternehmen voranbringen. Datenstandort und Zugriffe müssen zu den Anforderungen passen. Conventic deckt die ganze Bandbreite ab: von Cloud-KI bis zur eigenen KI im Unternehmen.
Lokale Wissenssuche
- Für Mittelstand und große Unternehmen
- Sicherheit und Datensouveränität von Anfang an
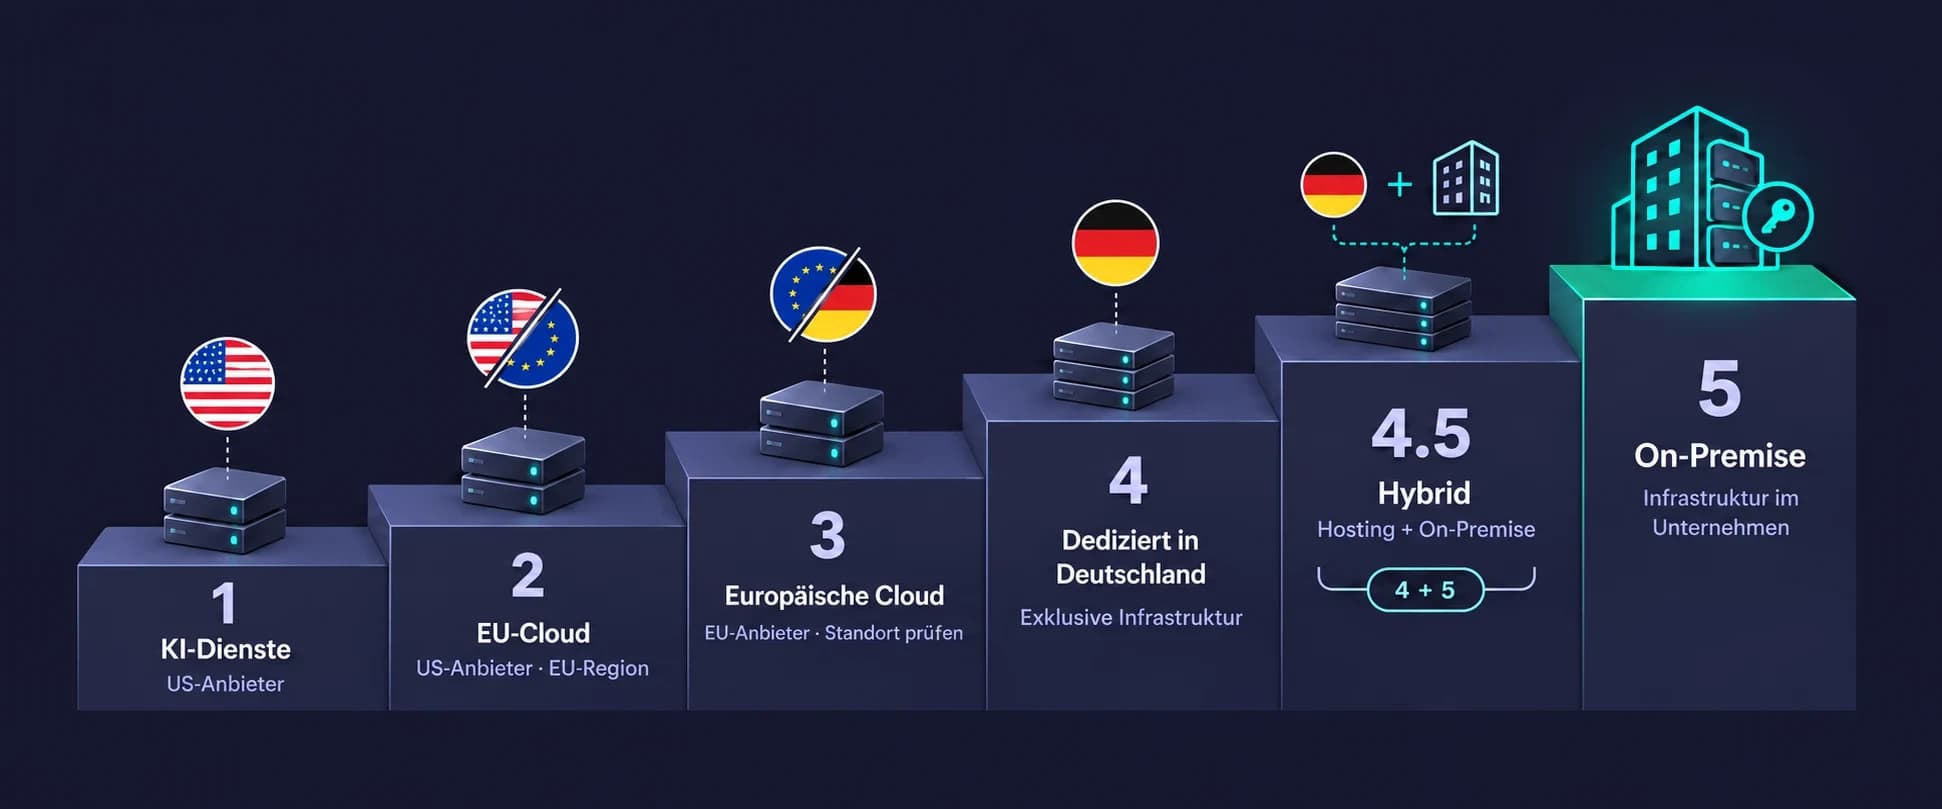
Die Hosting-Landkarte
Von KI-Diensten zur eigenen KI-Infrastruktur.
Conventic deckt die ganze Bandbreite ab. Die Ansätze zeigen unterschiedliche Möglichkeiten, Datenverarbeitung und Betrieb selbst zu gestalten.
 1
KI-Dienste
Modelle per Schnittstelle nutzen. Datenverarbeitung und Aufbewahrung richten sich nach Anbieter und Dienst.
 2
EU-Cloud (US-Anbieter)
EU-Datenhaltung bei US-Konzernanbietern. Ein möglicher US-Rechtszugriff bleibt zu berücksichtigen.
 3
Europäische Cloud
Europäische Infrastruktur wählen. Betreiberkette, Zugriffe und tatsächliche Datenflüsse bleiben entscheidend.
 4
Dediziert in Deutschland
Reservierte Rechenleistung beim deutschen Hostingpartner. Zugriffe und Betrieb werden gezielt geregelt.
 4.5
Hybrid (4 + 5)
Lokale KI mit dedizierter Kapazität in Deutschland kombinieren. Externe Verarbeitung nur nach Freigabe.
 5
On-Premise
KI in eigener Infrastruktur betreiben. Vollständig lokale Verarbeitung erfordert eine entsprechend ausgelegte Gesamtarchitektur.
Mehr Datensouveränität. Mehr Kontrolle über Datensicherheit.
Die Darstellung zeigt Gestaltungsspielräume, keine gemessenen oder zertifizierten Sicherheitsstufen. Tatsächliche Datensicherheit hängt von Architektur und Betrieb ab. Hybrid kombiniert 4 und 5 und ist keine zusätzliche Sicherheitsstufe.
EU-Rechenzentrum bedeutet nicht automatisch Schutz vor US-Rechtszugriffen. Entscheidend sind Rechtszuständigkeit und Kontrolle über die Daten. US CLOUD Act einordnen
Fünf Wege, KI zu betreiben. Die passende Lösung im Vergleich.
Die Ansätze unterscheiden sich beim Datenort, bei der Kontrolle und beim Betriebsaufwand. Ein Überblick für fundierte Entscheidungen.
Hosting-Ansatz auswählen
KI läuft im eigenen Unternehmen.
Modelle, Dokumente und Verarbeitung bleiben bei vollständig lokal ausgelegtem Betrieb in der eigenen Infrastruktur.
- Wo werden Daten verarbeitet?
- Vor Ort im Unternehmen oder im eigenen Rechenzentrum.
- Welche Kontrolle bleibt?
- Hardware, Modelle, Zugriffe und Netzwerkverbindungen liegen unter eigener Kontrolle.
- Rechtszugriff & Restrisiko
- Rein lokaler Betrieb ohne externen Anbieterzugriff reduziert den Weg einer Datenherausgabe über Cloud-Anbieter. Eine allgemeine Immunität gegen rechtmäßige Zugriffe entsteht nicht.
- Passt zu
- Unternehmen, deren sensible Daten die eigene Umgebung nicht verlassen sollen.
- Was ist abzuwägen?
- Hardware, Updates, Ausfallsicherheit und Betreuung müssen geplant und betrieben werden.
Lokale Wissenssuche
On-Premise-KI: Modelle, Dokumente und Verarbeitung bleiben bei vollständig lokal ausgelegtem Betrieb in der eigenen Infrastruktur.
Der Standort allein entscheidet nicht über Sicherheit oder Datensouveränität. Zugriffe, Verträge und der tatsächliche Datenfluss gehören immer dazu.
US CLOUD Act
EU-Rechenzentrum. US-Anbieter. Ein Risiko bleibt.
Ein europäischer Speicherort schützt nicht automatisch vor US-Herausgabeanordnungen. Für sensible Unternehmensdaten zählt auch, wer rechtlich und technisch Zugriff hat.
US-Recht kann über den Standort hinausreichen.
Der CLOUD Act stellt klar: Erfasste Anbieter unter US-Gerichtsbarkeit können durch rechtmäßige Anordnungen zur Herausgabe von Daten in ihrem Besitz, Gewahrsam oder ihrer Kontrolle verpflichtet werden, auch außerhalb der USA. Das ist kein pauschaler, anlassloser Behördenzugriff.
Die DSGVO gilt weiterhin.
Eine ausländische Anordnung allein schafft keine ausreichende Grundlage für eine Übermittlung. Erforderlich bleiben eine Rechtsgrundlage nach Artikel 6 und die Voraussetzungen aus Kapitel V der DSGVO. Widersprechende Pflichten sind möglich; Region und Vertrag allein lösen diesen Konflikt nicht.
Die Architektur entscheidet mit.
Betreiberkette, Zugriffsrechte, Schlüsselverwaltung und Verarbeitung im Klartext sind zu prüfen. Rein lokale KI ohne externen Anbieterzugriff reduziert den Herausgabeweg über Cloud-Anbieter, schafft aber keine allgemeine Immunität.
Conventic berücksichtigt diese Risiken bei der Auswahl und Auslegung der KI-Umgebung.
Zero Data Retention: weniger Speicherung, klare Grenzen.
Zero Data Retention (ZDR) begrenzt die Aufbewahrung von Eingaben und Antworten beim Modelldienst. Die Daten werden weiterhin dort verarbeitet. Umfang und Ausnahmen hängen von Anbieter, Modell, Funktion und Vereinbarung ab.
Kein Training heißt nicht: keine Speicherung.
Bei der OpenAI API werden Inhalte standardmäßig nicht zum Modelltraining genutzt. Trotzdem können Protokolle zur Missbrauchserkennung oder Daten einzelner Funktionen gespeichert werden. ZDR ist eine zusätzliche Regelung.
ZDR gilt für freigegebene Nutzung.
OpenAI und Anthropic knüpfen ZDR an eine Freigabe und konkrete Bedingungen. Nicht jedes Modell und jede Funktion ist abgedeckt; Sicherheits- und gesetzliche Ausnahmen sind zu prüfen. Eigene Anwendungslogs, Chatverläufe und angebundene Dienste brauchen separate Speicherregeln.
Weniger Datenbestand, kein Wegfall aller Risiken.
ZDR kann den später verfügbaren Datenbestand beim Anbieter reduzieren. Die Verarbeitung bleibt extern; Rechtszuständigkeit und mögliche rechtmäßige Zugriffe entfallen nicht automatisch. Für besonders sensible Daten bleibt vollständig lokale Verarbeitung eine eigene Architekturentscheidung.
Datensouveränität ist mehr als ein Standort.
Drei Fragen zeigen, wie viel Kontrolle über die KI beim Unternehmen bleibt.
Wo werden Daten verarbeitet?
Wir betrachten die gesamte Verarbeitung: Modell, Dokumente, Protokolle und Backups. Entscheidend ist, wo die Daten tatsächlich ankommen.
Wer betreibt die KI?
Anbieter, Unterauftragnehmer und Verträge bestimmen mit, welche Abhängigkeiten entstehen und welche Regeln gelten.
Wer darf worauf zugreifen?
Zugänge für Mitarbeitende, Administration und Support müssen klar geregelt sein. Ebenso wichtig: wer Daten lesen, verändern und löschen darf.
On-Premise-KI
Vertrauliche Daten. Eigene KI-Umgebung.
Interne Dokumente auswerten, Wissen auffindbar machen, Mitarbeitende unterstützen: Dafür müssen sensible Inhalte nicht automatisch an einen externen Modelldienst gehen. Wir konzipieren KI-Umgebungen so, dass die Verarbeitung lokal erfolgen kann.
Daten bleiben in der eigenen Umgebung.
Dokumente, Suchindex und Modell werden für den lokalen Betrieb zusammen geplant.
Zugriff folgt klaren Regeln.
Berechtigungen bestimmen, wer welche Informationen nutzen darf.
Verbindungen nach außen bleiben kontrollierbar.
Externe Schnittstellen werden bewusst freigegeben. Ein abgeschotteter Betrieb ist je nach Architektur möglich.
Modell und Hardware passen zur Aufgabe.
Wir wählen die Umgebung passend zu den Anwendungsfällen und Anforderungen.
Sicherer Betrieb braucht mehr als einen lokalen Server: Wir berücksichtigen Berechtigungen, Updates, Protokollierung, Backups und klare Verantwortlichkeiten. Welche Aufgaben Conventic übernimmt, wird passend zur Umgebung vereinbart.
Lokal arbeiten. Gezielt externe Kapazität nutzen.
On-Premise-KI wird mit dedizierter Rechenleistung in Deutschland kombiniert. Klare Regeln bestimmen, welche Daten und Aufgaben lokal bleiben und welche extern verarbeitet werden dürfen.
Zwei Umgebungen erhöhen den Abstimmungsaufwand. Hybrid ist eine Kombination, keine zusätzliche Sicherheitsstufe.
On-Premise-KI
Verarbeitung in der eigenen Umgebung.
Dedizierte GPU in DE
Externe Kapazität für freigegebene Verarbeitung.
Datenflüsse nach festgelegten Freigaberegeln
Eine klare Entscheidung. Ein nachvollziehbarer Weg.
Welche Daten darf die KI sehen? Welche Kontrolle ist nötig? Wie soll der Betrieb aussehen? Die Anforderungen bestimmen den Weg.
Anforderungen verstehen
Wir klären Anwendungsfälle, Daten, Schnittstellen und die Vorgaben der IT.
Architektur vergleichen
Das Ergebnis ist eine Empfehlung mit Datenflüssen, Zuständigkeiten und den relevanten Abwägungen.
Mit echten Aufgaben erproben
Wir prüfen die Lösung anhand vereinbarter Anwendungsfälle und freigegebener Daten.
Kontrolliert in Betrieb nehmen
Wir planen Einführung, Betreuung und Weiterentwicklung gemeinsam mit den Verantwortlichen.
Was Unternehmen wissen wollen.
Ist „kein Modelltraining“ dasselbe wie Zero Data Retention?
Nein. Der Verzicht auf Modelltraining regelt, wofür Inhalte genutzt werden. Zero Data Retention regelt die Aufbewahrung bei bestimmten API-Nutzungen. Auch ohne Training können beispielsweise Sicherheitsprotokolle oder gespeicherte Chatverläufe bestehen. Deshalb müssen Nutzung, Speicherung und Löschung getrennt geprüft werden.
Macht Zero Data Retention eine Cloud-KI so souverän wie On-Premise?
Nein. ZDR kann die Aufbewahrung beim Modelldienst begrenzen, verlagert die Verarbeitung aber nicht ins eigene Unternehmen. Anbieterzugriffe, Rechtszuständigkeit und Ausnahmen bleiben relevant. Zudem müssen die konkret eingesetzten Modelle und Funktionen für ZDR freigegeben sein. Eigene Anwendungslogs und weitere Dienste fallen nicht automatisch darunter.
Hebelt der US CLOUD Act die DSGVO aus?
Nein. Die DSGVO bleibt anwendbar. Zugleich können Anbieter unter US-Gerichtsbarkeit zur Herausgabe von Daten verpflichtet werden, die unter ihrer Kontrolle stehen, auch in EU-Rechenzentren. Eine solche Anordnung allein genügt nicht als Grundlage für die Übermittlung nach der DSGVO. Dadurch können widersprechende Pflichten entstehen. Für Unternehmen ist deshalb neben dem Standort entscheidend, welcher Anbieter tatsächlich Zugriff auf Daten hat.
Ist On-Premise-KI automatisch sicher?
Nein. Der lokale Betrieb ermöglicht direkten Einfluss auf Daten und Infrastruktur. Sicherheit entsteht durch die konkrete Umsetzung: etwa durch Berechtigungen, Netzwerktrennung, gepflegte Software und einen verlässlichen Betrieb.
Bedeutet ein EU-Rechenzentrum bereits volle Datensouveränität?
Der Datenort ist ein wichtiger Teil. Ebenso relevant sind der Betreiber, vertragliche Regelungen, mögliche Zugriffe und eingebundene Dienste. Wir betrachten diese Punkte gemeinsam, statt nur das Länderlabel zu prüfen.
Kann eine lokale KI ohne Internet arbeiten?
Bei passender Architektur können Modelle und Wissenssuche lokal ohne dauerhafte Internetverbindung arbeiten. Externe Funktionen, Aktualisierungen und Wartung müssen dafür gesondert geplant werden.
Müssen wir uns dauerhaft auf einen Ansatz festlegen?
Nein. Wir können einen schrittweisen Einstieg und spätere Erweiterungen vorsehen. Auch On-Premise-KI und dedizierte Rechenleistung in Deutschland lassen sich kombinieren. Welche Daten wohin gelangen, wird dabei ausdrücklich festgelegt.
Worauf basiert die Einordnung?
Die Übersicht vergleicht grundlegende Betriebsmodelle. Für einzelne Dienste zählen die aktuellen Anbieterbedingungen und die konkrete Konfiguration. Wir prüfen deshalb vor der Auswahl Datenflüsse, Betreiber, Zugriffe und vertragliche Regelungen. Die verlinkten Primärquellen helfen bei der Einordnung.
Die passende KI-Umgebung beginnt mit einem Gespräch.
Wir prüfen, welche Architektur zu den Unternehmenszielen, den Daten und der IT passt. Verständlich erklärt und mit einem klaren nächsten Schritt.